메타, 초대형 AI 학습 효율 지표 공개
인공지능신문 ·
✦ AI 요약
사전학습 굿풋 85% 이상·강화학습 90% 이상…뮤즈 원더 학습 중단 간 평균 약 4만7천 GPU 시간
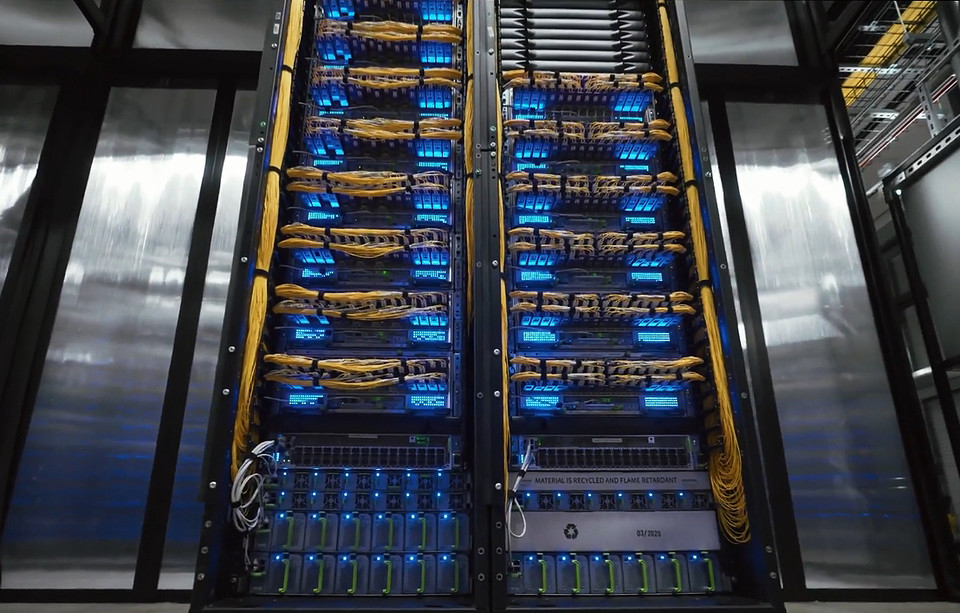
인공지능신문에 따르면 메타는 10월 19일 미국 오하이오주 뉴앨버니의 초대형 GPU 클러스터 '프로메테우스'로 뮤즈 기반 모델을 학습하며 사전학습 굿풋 85% 이상을 기록했다고 밝혔다. 강화학습에서도 높은 효율을 냈고, 메타는 이를 통해 대규모 학습에서 단순한 GPU 확보보다 실제 유효 연산과 중단 억제가 더 중요하다는 점을 드러냈다. 기사에 따르면 수십만 개 GPU를 묶은 환경에서는 장비 한 곳의 성능 저하만으로도 전체 학습 속도가 늦어질 수 있다. 그래서 이번 공개의 핵심은 모델 성능 자체보다 클러스터 전반의 병목과 불안정을 어떻게 줄였는지에 있다. 다만 메타가 제시한 지표는 자체 공개 수치여서 외부 검증이나 경쟁사와의 직접 비교 근거로 보기는 어렵다. 세부 산정 방식과 복구 기술까지 공개되지는 않아, 실제 운영 전략의 차이는 원문에서 확인할 대목으로 남는다.
관점
이번 공개는 AI 경쟁의 기준이 칩을 얼마나 많이 모았는지에서 그 자원을 얼마나 끊김 없이 학습 성과로 바꾸는지로 옮겨가고 있음을 보여줍니다. 같은 규모의 인프라라도 운영 능력에 따라 개발 속도와 비용 효율이 크게 달라질 수 있어, 앞으로는 모델 발표 못지않게 학습 시스템의 안정성과 자원 활용 방식이 기업 경쟁력을 가르는 요소가 될 가능성이 큽니다.
이 관점은 비즈크러시가 작성한 자체 의견이며, 인공지능신문의 보도 내용과 무관합니다.
이 기사는 자동생성 알고리즘의 도움을 받아 작성되었습니다.
출처 인공지능신문
원문 확인이 기사는 인공지능신문 원문을 바탕으로 비즈크러시가 요약 정리했습니다. 정확한 인용과 세부 내용은 원문을 확인해 주세요.