[AI 레디 데이터②] AI가 기업 데이터 이해하려면…‘업무 맥락’까지 연결해야
아이티데일리 (IT DAILY) ·
✦ AI 요약
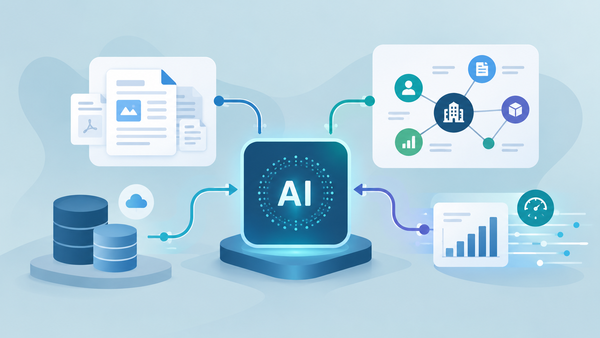
기업 실무에서 생성형 AI·AI 에이전트 활용이 확산되며, AI 레디 데이터와 데이터 의미·최신성·접근권한의 일관 관리 필요성이 커지고 있다.
지티원과 엔코아는 메타데이터, 온톨로지, 데이터 카탈로그, 데이터 맥락지도와 의미 모델로 업무 맥락을 구조화해 AI가 이해할 수 있는 데이터 체계를 제시했다.
위세아이텍, 데이터스트림즈, IBM은 비정형 문서 관리, CDC·스트리밍·데이터 패브릭, 실시간 데이터 처리와 거버넌스를 통해 AI 활용용 데이터를 공급하는 방안을 소개했다.
생성형 인공지능(AI)·AI 에이전트 활용의 기업 실무 확산으로 기업 데이터 관리에 새로운 기준이 요구되고 있다. 기업들은 기존에 데이터 수집·정제·분석 체계를 갖춰 왔지만, 기존 데이터는 AI 활용에 부적합할 가능성이 제기된다. 데이터가 여러 시스템에 분산됐고 동일 정보라도 업무별 의미·관리 기준이 상이하기 때문이다.
AI의 데이터 직접 탐색·해석·업무 활용이 이뤄지는 환경에서는 데이터 품질의 일관 관리뿐 아니라 데이터 의미의 일관 관리, 최신성의 일관 관리, 접근권한의 일관 관리에 대한 필요성이 확대되고 있다. 이런 변화 속에서 주목받는 개념이 'AI 레디 데이터(AI Ready Data)'다. 이는 단순 수집·정제를 넘어 AI의 데이터 의미·맥락 이해 가능 상태를 준비하고, AI가 데이터를 신뢰할 수 있도록 준비하는 데 핵심이 있다.
아이티데일리는 AI 레디 데이터②를 통해 기업 AI 활용 확대에 따른 데이터 관리 요건을 점검하고, AI 레디 데이터 구축 과정의 과제를 조명하며, 기술적 접근 방식과 실제 적용 사례를 다룬다. 이번 기획은 총 3편으로 구성된다.
AI 시대에는 좋은 데이터의 기준이 달라지고 있으며, AI가 기업 데이터를 이해하려면 업무 맥락의 연결이 필요하다고 지티원은 판단했다.
이에 따라 AI를 위한 맥락 구조화의 대상은 데이터 정의를 넘어 업무 관계까지 포함되며, 데이터 범위와 검증 기준을 마련한 이후 단계로 업무 지식의 구조화가 제시됐다.
이 같은 구조화의 목적은 기업이 보유한 지식을 AI 서비스가 공통으로 활용할 수 있는 형태로 전환하는 데 있다.
이를 위한 활용 수단으로는 데이터 카탈로그가 제시됐으며, 데이터 카탈로그는 필요한 데이터를 탐색하는 기능과 해당 데이터의 업무 활용처를 확인하는 기능을 맡는다.
다만 데이터 카탈로그를 지속적이고 일관되게 운영하려면 메타데이터 관리가 필요하며, 메타데이터에는 데이터 명칭과 데이터 구조, 업무에서 사용하는 정의가 포함된다.
지티원은 이 같은 메타데이터를 통해 기업 내부 업무 용어와 AI 활용 데이터 사이에 공통 기준을 마련할 수 있다고 봤다.
지티원 관계자는 메타데이터의 역할에 대해 AI의 자의적 데이터 해석을 막고, 데이터의 의미·구조·속성·관계를 표준화하며, 공통 언어로 기능하는 데 있다고 밝혔다. 이어 업무 용어와 논리·물리 데이터의 관계를 연결하고, 업무상 의미와 실제 데이터·AI가 이해하는 의미가 일치하는 기반을 제공하는 것이 메타데이터라고 설명했다.
그러나 메타데이터만으로는 실제 업무의 복잡한 관계와 판단 규칙을 표현하는 데 제약이 있다는 지적이 나온다. 엔코아는 이런 한계를 보완하는 방향으로 온톨로지에 주목하고 있다.
엔코아 관계자는 메타데이터만으로는 데이터의 업무상 의미와 다른 데이터와의 관계를 충분히 설명하기 어렵다고 밝혔다. 그러면서 해당 한계를 보완하는 수단으로 온톨로지를 제시했다.
온톨로지는 고객·주문·계약 등 업무 개체의 속성·관계·규칙을 정의한 지식 체계로, 사람과 기계가 함께 이해 가능한 형태로 구성된다. 이를 지식그래프로 구현하면 AI의 단순 유사어 검색 한계를 완화할 수 있고, AI가 업무 개체 간 관계와 규칙을 따라 필요한 근거를 탐색할 수 있게 된다.
엔코아는 기업 공통 데이터 정의를 바탕으로 기업 전반의 데이터 구조와 공통 개념을 연결하기 위한 데이터 맥락지도(Context Map)를 구성하고 있다. 이를 토대로 개별 업무별 판단 기준과 관계 연결 방식을 반영해 특정 업무별로 필요한 의미 모델(Semantic Model)과 실제 데이터의 관계를 단계적으로 결합하는 방식으로 업무 맥락을 만든다.
엔코아는 이렇게 구축한 업무 맥락을 개별 프로젝트에 소모하지 않고 다른 AI 에이전트에서도 활용할 수 있도록 하는 가능성을 고려하고 있다. 또한 구축한 업무 맥락을 공통 자산으로 관리하는 데 초점을 맞추고 있다.
엔코아 관계자는 핵심은 첫 번째 AI 프로젝트의 성공에만 머무르지 않는 것이라고 밝혔다. 이어 첫 과제에서 확인한 데이터 의미와 판단 기준을 다음 과제의 출발점으로 남겨야 하며, 그래야 AI 투자가 개별 PoC의 반복이 아니라 기업의 장기 데이터 자산으로 축적될 수 있다고 설명했다.
사진은 엔코아가 제공했다.
AI 레디 데이터 구축 적용 방법론은 기업의 업무 지식이 데이터베이스뿐 아니라 계약서, 업무 보고서, 매뉴얼 등 비정형 문서에도 축적돼 있다는 점을 전제로 한다. 이들 문서를 AI 서비스에 활용하려면 문서의 내용을 분석하고 필요한 정보를 추출하는 과정이 필요하다.
지티원 관계자는 비정형 데이터는 문서가 존재하는 것만으로는 AI가 업무적 의미와 다른 데이터와의 관계를 이해하기 어렵다고 설명했다. 이어 문서 내용에서 주요 용어와 분류, 요약, 관계를 추출해야 하며, 이렇게 추출한 정보는 기존 정형 데이터와 연계해 관리할 필요가 있다고 밝혔다.
실제 구축 과정에서는 PDF·워드·한글 문서 등 다양한 형식의 자료를 분석하고 주요 정보를 추출한다. 이후 추출한 내용을 기존 정형 데이터와 연결하는 방식으로 구축이 이뤄진다.
이 과정에서는 문서를 소단위로 분할해 AI 검색을 지원하는 청킹(Chunking)과 텍스트를 벡터로 변환하는 임베딩(Embedding) 기술이 활용된다. 가공한 정보는 RAG용 문서 집합과 벡터 데이터베이스(DB) 형태로 제공된다.
검색용 자료는 문서 가공 이후에도 검색 대상 자료의 유효성을 관리할 필요가 있다는 문제의식이 제기된다. 동일 업무 문서라도 작성 시점별로 내용 차이가 날 수 있고, 개정 규정·계약 조건이 과거 자료와 함께 잔존할 수 있어서다. 이에 따라 검색 대상 문서의 내용을 파악할 필요가 있으며, 현재 유효한 자료인지 확인할 수 있는 정보의 관리도 필요하다.
위세아이텍 관계자는 비정형 데이터의 경우 파일명·저장 위치·확장자만으로는 활용에 필요한 정보를 파악하기 곤란하다고 설명했다. 그러면서 내용과 관련 업무, 출처, 담당자, 현재 유효성을 확인할 수 있어야 한다고 설명했다.
위세아이텍은 이에 대응해 데이터 자산관리 솔루션 '와이즈그랑데이터(WiseGrandata)'의 출시를 준비하고 있다. '와이즈그랑데이터(WiseGrandata)'는 조직에 분산된 정형·비정형 데이터의 메타정보를 수집·목록화하고, 필요한 데이터의 검색·탐색을 지원하는 제품이다. 위세아이텍은 수집 데이터의 유형·업무 분야 자동 분류 기능과 태그·내용 설명 추천 기능을 계획하고 있으며, 기존 보관 문서를 현업 사용자·AI 개발자가 찾아 활용할 수 있는 자산으로 관리하는 데 초점을 두고 있다.
AI 활용에는 정보의 정확한 검색·활용에 더해 데이터의 적시 공급 과제가 제기된다. 주문·재고 등 수시 변경 정보를 활용할 때는 기존 저장 데이터만으로 현재 업무 상황을 정확하게 반영하는 데 한계가 있다. 이에 따라 원천 시스템의 변경 사항을 필요한 시점에 AI로 전달하는 체계가 요구된다.
김용민 한국IBM CSE는 기업들이 AI·분석·자동화에서 몇 시간 전·며칠 전이 아닌 현재 데이터를 반영하기를 기대한다고 밝혔다. 그러나 많은 기업의 현황은 야간 배치로 적재한 전일 데이터에 의존하는 수준이며, 그 결과 실시간이 아닌 데이터 기반으로 분석과 의사결정을 하는 상황이라고 설명했다.
이 같은 한계에 대응해 데이터스트림즈는 기존 데이터 웨어하우스·데이터 레이크에 데이터 패브릭(Data Fabric)을 결합하고 있다. 데이터 패브릭(Data Fabric)은 서로 다른 시스템 데이터의 통합 연결·활용을 지원하는 기술 구조다. 데이터스트림즈는 이를 바탕으로 AI 데이터 플랫폼으로의 확장을 추진하고 있다.
운영 방식에서는 기존 주기적 데이터 수집 체계를 유지한다. 여기에 실시간 데이터 처리와 데이터 가상화를 추가 요소로 결합하고 있다. 데이터스트림즈는 기존 저장 중심 체계에 이 같은 요소들을 더하는 방향으로 대응하고 있다.
데이터 공급에 활용되는 핵심 기술로는 변경데이터캡처(CDC)와 스트리밍이 있다. CDC는 원천 데이터베이스의 변경 사항을 포착해 다른 시스템으로 전달하는 개념이다. 스트리밍은 연속 발생하는 데이터를 수집·처리해 AI가 최신 정보를 활용하도록 지원하는 개념이다.
데이터스트림즈는 기존 데이터 통합 솔루션 '테라스트림(TeraStream)'에 CDC 솔루션 '델타스트림(DeltaStream)'을 결합하는 구성을 갖췄다. 또 '테라스트림(TeraStream)'에는 스트리밍 처리 제품 '테라스트림 배스(TeraStream BASS)' 등을 결합하는 방식도 제공한다.
데이터가 여러 시스템에 저장된 경우에는 분산 질의·데이터 가상화를 지원하는 '테라원 슈퍼쿼리(TeraOne SuperQuery)'를 활용한다. 데이터스트림즈 관계자에 따르면 '테라원 슈퍼쿼리(TeraOne SuperQuery)'는 데이터 이동·복제 대신 연결·가상화·메타데이터 기반 방식을 사용한다. 또 필요한 데이터를 적시에 찾아 연결하도록 한다.
IBM은 실시간 데이터 처리 기술에 자사 데이터 관리 체계를 결합해 실시간 데이터 공급 체계를 확장하고 있다. 데이터 스트리밍 기술과 기존 데이터 관리 플랫폼의 결합을 통해 데이터 수집·통합부터 실제 AI 활용까지 단일 흐름으로 연결하는 IBM 전략을 추진하고 있다.
이 흐름에서 IBM은 컨플루언트 기술 활용을 통해 데이터를 실시간 수집·처리하고, 개방형 하이브리드 레이크하우스 '왓슨x.데이터(watsonx.data)'를 활용해 온프레미스·클라우드 데이터를 통합한다. 이어 '왓슨x.데이터 인텔리전스(watsonx.data intelligence)'와 연계해 데이터 품질 관리와 데이터 계보 관리, 데이터 접근 정책 관리를 수행함으로써 AI 활용 단계까지 이어지게 하는 구조를 갖췄다.
김용민 한국IBM CSE는 IBM 왓슨x.데이터와 컨플루언트를 결합하면 실시간 비즈니스 이벤트를 거버넌스가 적용된 AI 레디 데이터로 전환할 수 있다고 밝혔다. 또 AI 에이전트가 데이터를 빠르고 확신 있게 활용할 수 있으며, 데이터 생성 시점부터 AI 활용 시점까지 전 과정을 실시간 단일 흐름으로 연결할 수 있다고 설명했다.
출처: 아이티데일리 (IT DAILY) · 양승갑 기자
원문: https://www.itdaily.kr/news/articleView.html?idxno=242051
참고자료
이 기사는 자동생성 알고리즘의 도움을 받아 작성되었습니다.
출처 아이티데일리 (IT DAILY)
원문 확인이 기사는 아이티데일리 (IT DAILY) 원문을 바탕으로 비즈크러시가 요약 정리했습니다. 정확한 인용과 세부 내용은 원문을 확인해 주세요.