오픈소스 AI 시대 2대 과제…‘에이전트 표준’과 ‘데이터 공급망 리스크’
아이티데일리 (IT DAILY) ·
✦ AI 요약
'오픈소스 테크데이 2026'은 과학기술정보통신부·국가과학기술연구회(NST)가 주최했으며, 기조연설에서는 에이전틱 AI의 실전 배치에 따른 표준과 컴플라이언스 과제가 다뤄졌다.
마진 길버트는 에이전트 인터넷 구축을 위해 MCP·A2A 같은 개방형 표준과 L4 플랫폼 표준이 필요하다고 주장했다.
이화영 상무는 데이터 99%가 오픈 데이터와 합성 데이터에 의존하는 환경에서 라이선스 체인 오염을 막기 위한 AI-BOM과 데이터 컴플라이언스 체계를 제시했다.
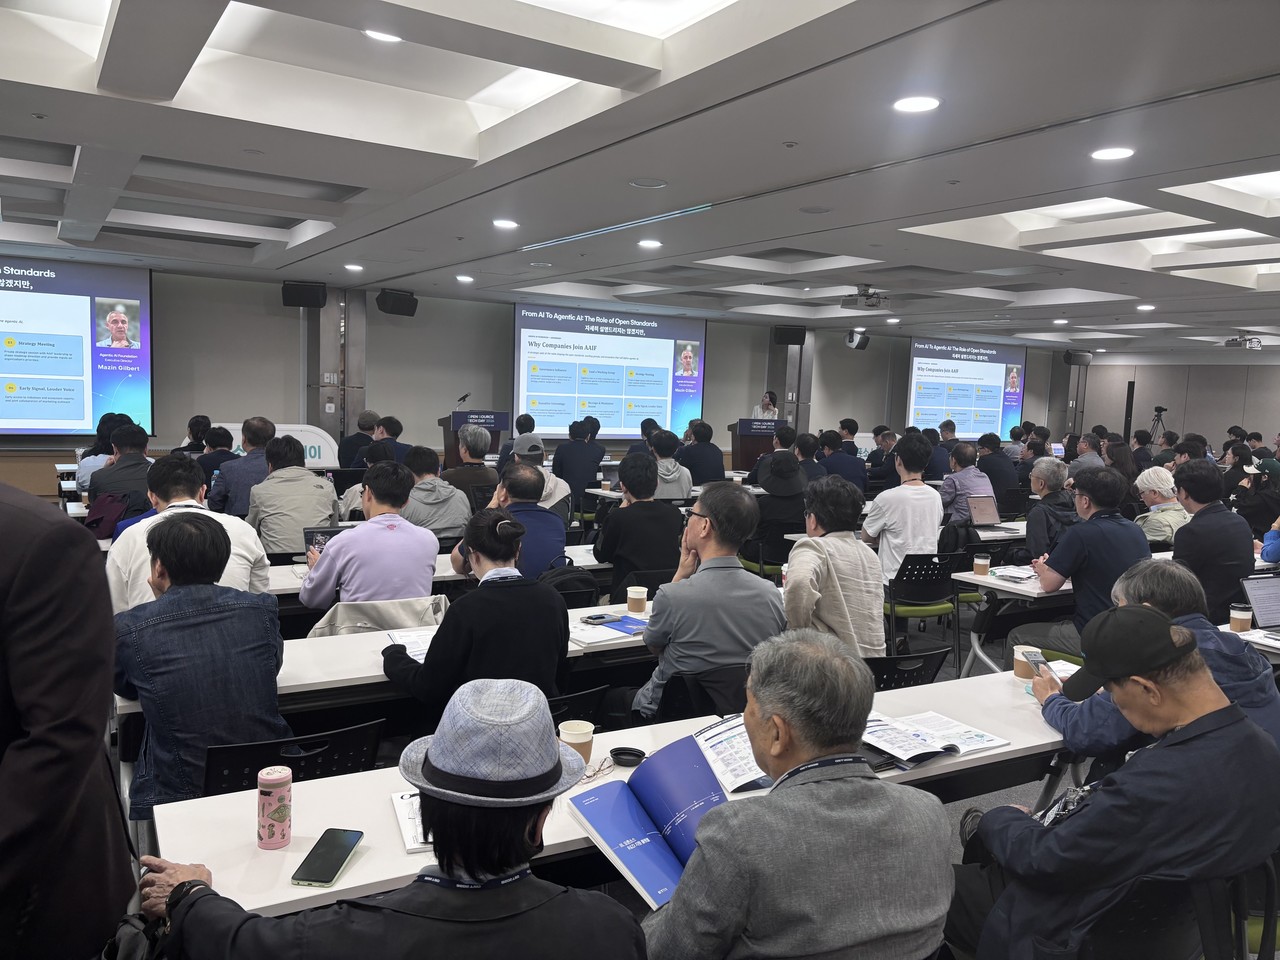
'오픈소스 테크데이 2026' 현장 사진은 권영석 기자가 제공했다. 에이전틱 AI가 실전 배치되면서 오픈소스 진영의 관심은 기술 자체를 넘어 운영 가능한 기준과 준수 체계로 옮겨가고 있다. '오픈소스 테크데이 2026'은 과학기술정보통신부·국가과학기술연구회(NST)가 주최했으며, 기조연설 세션에서는 이런 산업계의 고민이 표출됐다. 연사 구성은 글로벌 오픈소스 재단·국내 AI 연구진으로 이뤄졌다.
이 자리에서는 오픈소스 진영의 핵심 실무 과제로 상호운용성 표준·데이터 공급망 컴플라이언스의 2가지가 제시됐다. 한편으로 독점적 빅테크에 대한 대응 수단으로는 개방형 프로토콜 선점이 거론됐다. 다른 한편으로 학습 데이터의 99%를 외부 오픈 데이터에 의존하는 환경에서 주요 리스크로는 라이선스 연쇄 오염이 지목됐다. 이에 따라 AI 기업들의 생존 변수로는 개방형 프로토콜 선점·라이선스 연쇄 오염 차단이 함께 제시됐다.
이런 배경 속에서 행사 기조연설 세션에서는 두 가지 전략이 함께 제시됐다. 제시 전략 1은 에이전트 간 연결용 'L4 플랫폼 표준'이었고, 제시 전략 2는 데이터 계보 증명용 '인공지능 자재명세서(AI-BOM)'였다. 이는 에이전틱 AI 실전 배치 국면에서 연결 표준 확보와 데이터 출처 및 라이선스 관리가 함께 요구되고 있음을 보여줬다.
리눅스 재단 산하 에이전틱 AI 재단(AIF)의 첫 번째 기조연설자로 나선 마진 길버트(Mazin Gilbert) 총괄 디렉터는 영상 기조연설을 진행하며 핵심 메시지로 에이전트 인터넷 시대의 개막을 제시했다. 사진은 권영석 기자가 촬영했다.
길버트는 AI의 진화가 단일 턴 질의응답 단계를 이미 초과했다고 진단했다. 그는 AI가 스스로 도구를 사용하며 목표를 수행하는 에이전틱 시스템으로 진화하고 있다고 설명했다.
길버트는 거시적 시장 분석을 바탕으로 '에이전트의 인터넷(Internet of Agents, IoA)' 구축을 위한 개방형 표준의 필요성을 주장했다. 그는 과거 웹 생태계가 TCP/IP·HTTP 등 개방형 프로토콜과 중립 거버넌스를 기반으로 성장한 점을 비교 대상으로 들며, 에이전트 인터넷에도 동일한 기반이 필수라고 밝혔다.
길버트는 표준이 부재할 경우 특정 빅테크의 독점이 심화할 수 있다고 짚었다. 그는 표준 부재를 체계적 리스크로 규정했으며, 에이전트와 도구 간 연동이 N×M 연결 형태로 무분별하게 파편화돼 막대한 통합 비용이 발생할 수 있다고 설명했다.
지난 1년 토큰 가격 90% 하락에도 같은 기간 사용량은 50배 증가한 것으로 나타났다. 이는 '제본스의 역설(Jevons Paradox)'에 해당하는 현상으로 제시됐다. 또한 오픈 모델·폐쇄형 모델 성능 격차 축소가 불과 4개월 수준에 이르렀다는 분석과 함께, 모델 자체 차별성은 점진적으로 평준화되고 있다는 흐름이 제시됐다.
이 같은 흐름에 따라 그는 에이전틱 AI 스택 5개 계층 중 '에이전틱 플랫폼'을 향후 시장 핵심 승부처로 지목했다. 길버트 디렉터는 실질적 부가가치 발생 지점이 L4 계층에 있다고 봤다. L4 계층은 런타임·인증·관찰가능성·에이전트 간 통신 조율 기능을 담당한다. 길버트 디렉터는 MCP·A2A 등 개방형 표준 선점이 필요하다고 밝혔으며, 개방형 표준 선점은 통합 비용 절감과 네트워크 효과 극대화로 이어진다고 설명했다.
AIF 조사 결과에 따르면 회원사 81%는 프로덕션 단계 운용 중인 것으로 나타났다. 또 AIF 조사 결과 회원사 89%는 MCP를 평가·도입 중인 것으로 조사됐다. 이 같은 수치는 경쟁의 중심이 모델 위 계층으로 이동하는 전환이 실제 도입 단계에서 진행 중임을 보여준다.
권영석 기자가 촬영한 사진에는 이화영 LG AI연구원 상무가 담겼다. 이화영 상무는 두 번째 기조연설을 맡아 라이선스 체인 오염 방지를 위한 'AI-BOM'의 필요성을 주제로 제시했다.
이화영 상무는 대규모 학습 데이터 공급망 전반의 법적 리스크를 진단하고, LG AI연구원이 자체 개발한 실무 컴플라이언스 체계를 공유하면서 해결책도 함께 제시했다. 그는 학습 데이터 규모가 40조~400조 토큰으로 급증했고, 데이터 99%를 웹 크롤링 등 오픈 데이터와 합성 데이터에 의존하는 구조라고 설명했다.
그는 이 같은 구조를 배경으로 수집 단계의 저작권 침해 리스크와 가공 단계의 저작권 침해 리스크, 사전학습 및 배포 단계의 저작권 침해 리스크, 추론 단계의 저작권 침해 리스크를 설명했다. 이어 공급망 전 주기에서 저작권 침해 리스크가 연쇄적으로 발생한다고 짚었다.
특히 수십 개 하위 데이터셋의 병합·재배포 과정이 존재하는 가운데, 원저작자의 조건 사례인 '비상용(Non-Commercial)'이 오픈소스 포털을 경유하면서 라이선스 변경 문제를 일으킨다고 설명했다. 이 과정에서 '비상용(Non-Commercial)' 조건이 아파치(Apache) 또는 MIT 같은 상용 라이선스로 둔갑하는 변질 사례가 나타난다고 밝혔다.
이화영 상무는 이 같은 현상이 공급망 전 주기의 저작권 리스크와 맞물린다고 짚으면서, '라이선스 체인 오염'을 심각한 병목으로 지목했다. 그는 이러한 문제에 대응하기 위한 해결책도 공유했다.
LG AI연구원은 데이터 활용 적합성 문제를 막기 위해 데이터 컴플라이언스 체계와 에이전틱 AI 기반 자동화 검증 해법을 함께 도입했다. 데이터는 상업적 이용 가능 여부 등 18개 항목을 기준으로 삼고, 18개 항목별 가중치를 부여해 A·B·C로 등급화한다. A 등급은 상용 배포 가능, B 등급은 제한적 내부 활용, C 등급은 사내 연구 전용을 뜻한다.
이 체계에는 워스트 케이스(Worst-Case) 슈퍼셋 원칙이 적용된다. 하위 데이터셋 1개라도 C등급이 포함되면 전체 모델 등급을 강등하는 방식이다. LG AI연구원은 기존에 데이터셋 1개를 검토하는 데 수주일이 소요됐고, 그 원인으로 변호사의 수작업 병목이 있었다고 보고, 소스 추적·라이선스 평가를 자율 수행하는 에이전트를 구축하는 것을 해결 목적으로 삼았다.
이에 따라 검토 체계는 에이전트가 1차 검토를 맡고 변호사가 최종 교차 검증하는 구조로 마련됐으며, 해당 시스템은 11월 대외 오픈될 예정이다. 이 상무는 베이스 모델·파인튜닝 데이터·라이선스 등급을 투명하게 추적할 수 있는 인공지능 자재명세서(AI-BOM)의 제도화가 필요하다고 밝혔고, AI-BOM 제도화가 유럽연합(EU) AI Act 등 글로벌 규제 장벽에 대응하기 위한 조건이라고 밝혔다.
현장 질의응답에서 발언자는 출처 불분명 블랙박스 모델이 무위험이 아니며, 기업이 그 위험을 전부 부담하는 상태라고 설명했다. 이어 발언자는 투명한 데이터 계보를 확보할 필요가 있으며, 투명한 데이터 계보가 오픈소스 AI 생태계의 지속 가능성을 강화한다고 밝혔다.
출처: 아이티데일리 (IT DAILY) · 권영석 기자
원문: https://www.itdaily.kr/news/articleView.html?idxno=242046
참고자료
이 기사는 자동생성 알고리즘의 도움을 받아 작성되었습니다.
출처 아이티데일리 (IT DAILY)
원문 확인이 기사는 아이티데일리 (IT DAILY) 원문을 바탕으로 비즈크러시가 요약 정리했습니다. 정확한 인용과 세부 내용은 원문을 확인해 주세요.