AI 보안 역량도 점수로…‘사이버 지수’ 등장
아이티데일리 (IT DAILY) ·
✦ AI 요약
아티피셜 애널리시스는 28일(현지시간) AI의 사이버보안 능력을 수치화한 새 지표 '사이버 지수'를 발표했다. 이 지표는 취약점 발견·검증·조치 전 과정을 평가한다.
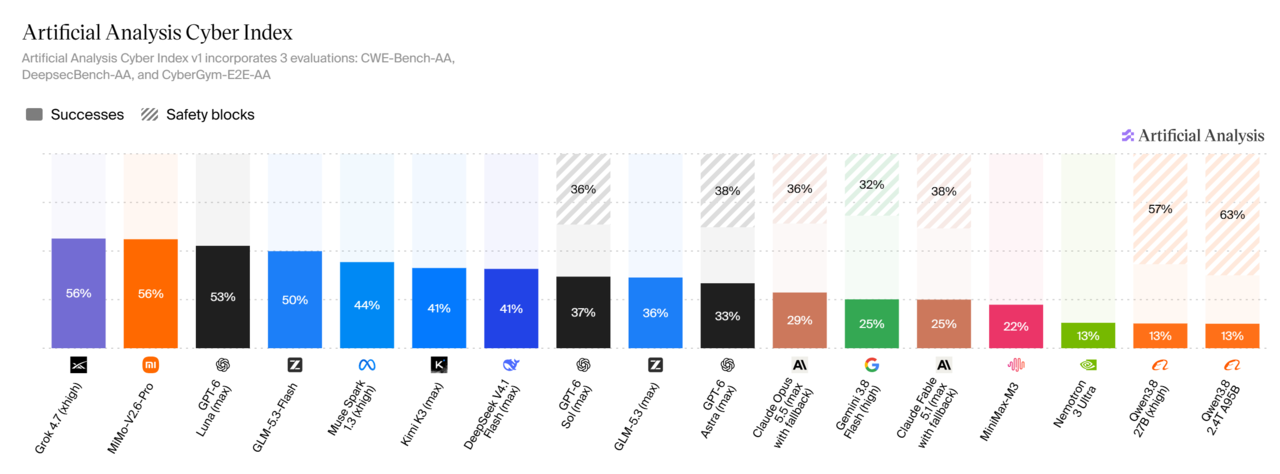
첫 평가에서는 스페이스XAI '그록 4.7'과 샤오미 '미모 V2.6 프로'가 공동 1위로 56점을 기록했다. 오픈AI 'GPT-6 루나(Luna)' 추론 '맥스(Max)' 설정은 53점, 즈푸AI(Z.ai) 'GLM 5.3 플래시'는 50점을 받았다.
일부 프런티어 AI 모델은 안전장치 문제로 과제를 거부하거나 테스트가 차단됐고, 아티피셜 애널리시스는 거부한 모델에 0점을 부여했다. 이 지수는 아티피셜 애널리시스가 IBM·엔비디아(NVIDIA)·콜리니어AI·버셀과 공동 제작했다.
아티피셜 애널리시스는 28일(현지시간) AI의 사이버보안 능력을 수치화하기 위한 새 지표인 '사이버 지수'를 발표했다. '사이버 지수'는 사이버보안 분야 AI 모델 역량 평가 지표이며, 평가 범위는 취약점 발견·검증·조치 전 과정이다.
아티피셜 애널리시스가 공개한 첫 평가에서는 스페이스XAI '그록 4.7'과 샤오미 '미모 V2.6 프로'가 공동 1위를 기록했다. 공동 1위 점수는 56점이다.
다만 일부 주요 AI 기업 프런티어 모델은 안전상 이유로 특정 평가 과제를 다수 거부했다. GPT-6 아스트라 등 프런티어 AI 모델은 안전장치 문제로 테스트가 차단됐고, 해당 모델들은 평가를 실시하지 못했다. 이 같은 프런티어 모델의 과제 거부와 테스트 차단으로 역량 비교의 한계가 노출됐다.
아티피셜 애널리시스는 IBM·엔비디아(NVIDIA)·콜리니어AI(Collinear AI)·버셀(Vercel)과 함께 지수를 공동 제작했다. 이 과정에서 IBM·엔비디아(NVIDIA)는 방법론 관련 전문가 의견을 제공했고, 콜리니어AI(Collinear AI)·버셀(Vercel)은 평가 과정에 참여했다. 이번 협력을 계기로 협의체 '사이버 지수 연합(Cyber Index Alliance)'도 출범했다.
사이버 지수 산출 방식은 CWE-벤치-AA·딥섹벤치-AA·사이버짐-E2E-AA를 동일 비중으로 반영하는 구조다. 각 벤치마크는 취약점 탐지·검증·패치 개발 등 상이한 방어 역량을 측정하며, 종합 결과는 0~100점으로 환산해 표기한다. 평가는 소스코드 접근 가능 환경에서의 취약점 탐지·조치 능력을 대상으로 하며, 침해사고 대응은 평가 범위에서 제외한다.
아티피셜 애널리시스가 28일(현지시간) '사이버 지수'를 발표했다. 이번 평가는 모델들의 사이버 지수 점수와 과제당 비용을 함께 비교했으며, 지수 측정 항목은 보안 역량과 토큰 비용이었다.
점수에서는 첫 공개 평가 결과 1위로 스페이스XAI '그록 4.7' xhigh 설정과 샤오미 '미모 V2.6 프로'가 올랐다. 두 모델의 사이버 지수는 56점이었다. 이어 오픈AI 'GPT-6 루나(Luna)' 추론 '맥스(Max)' 설정은 53점, 즈푸AI(Z.ai) 'GLM 5.3 플래시'는 50점을 기록했다.
비용에서는 오픈AI 'GPT-6 루나(Luna)' 추론 '맥스(Max)' 설정이 과제당 비용 최저를 기록했으며, 작업당 0.12달러(약 163원)였다. 샤오미 '미모 V2.6 프로'는 전체 평가 공동 1위이면서 작업당 0.18달러(약 244원)였다. 같은 상위권 모델끼리도 비용 효율 차이가 크게 나타났으며, 스페이스XAI '그록 4.7'은 최고 점수권이면서 작업당 11.67달러(약 1만5861원)로 평가 대상 중 비용이 가장 컸다.
사이버 지수는 AI 모델 보안 역량을 검증할 수 있다는 의의를 지닌 지표로 제시됐다. 다만 이번 발표에서는 프런티어 AI가 포함되지 않았다. 이는 모델·서비스 제공자의 안전장치가 취약점 검증의 일부 작업을 차단했기 때문이다. 오픈AI의 'GPT-6 아스트라(Astra)'는 사이버짐-E2E-AA 벤치마크 과제를 약 98% 거부했고, 앤트로픽의 '클로드 페이블(Claude Fable) 5.1'도 사이버짐-E2E-AA 벤치마크 과제를 약 98% 거부했다. 알리바바의 '큐원(Qwen) 3.8 2.4T A95B'와 '큐원 3.8 27B'는 벤치마크 과제를 전부 차단했다.
이에 아티피셜 애널리시스는 과제를 거부한 모델에 0점을 부여했다. 동시에 거부율은 별도로 표기했다.
아티피셜 애널리시스는 2023년에 설립된 기관으로, 언어모델·에이전트 지능·이미지·비디오·음성 등 AI 스택 전반을 평가하는 글로벌 벤치마크 기관이다. 이 기관은 500개 초과 모델을 분석 대상으로 삼고 있으며, 평가 결과는 주요 AI 기업들이 인용하고 있다.
출처: 아이티데일리 (IT DAILY) · 김호준 기자
원문: https://www.itdaily.kr/news/articleView.html?idxno=241886
참고자료
이 기사는 자동생성 알고리즘의 도움을 받아 작성되었습니다.
출처 아이티데일리 (IT DAILY)
원문 확인이 기사는 아이티데일리 (IT DAILY) 원문을 바탕으로 비즈크러시가 요약 정리했습니다. 정확한 인용과 세부 내용은 원문을 확인해 주세요.