래블업, GPU 관리 넘어 ‘AI 운영체계’로 간다
테크월드뉴스 ·
✦ AI 요약
래블업은 GPU·AI 클러스터 관리에서 모델 학습·추론, 토큰 사용량 관리, AI 에이전트 운영까지 사업 범위를 넓히고 있다.
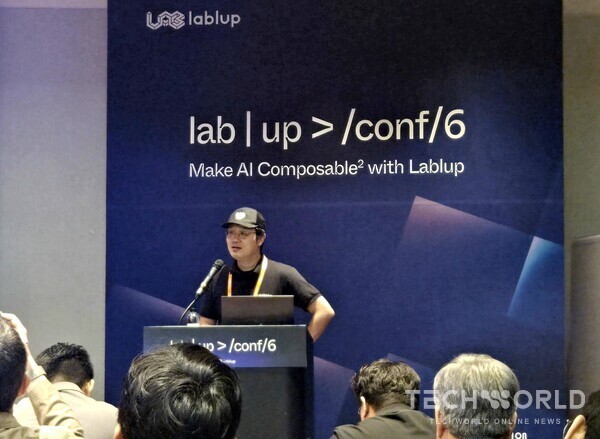
신정규 대표는 29일 서울 코엑스에서 열린 'lab | up > /conf/6' 오프닝 키노트에서 인프라부터 업무 수행까지를 하나의 운영 체계로 연결할 필요가 있다고 밝혔다.
래블업은 '토큰 팩토리', '컨티넘', '누빔(NeuVM)', 에이전트 플랫폼과 'AI:GO'를 통해 학습·추론·요청 관리·에이전트 운영을 묶는 구조를 구상하고 있다.
래블업은 GPU·AI 클러스터 관리에 머물지 않고 AI 활용의 전 단계를 포괄하는 방향으로 사업 범위를 확대하고 있다. 기존 범위는 GPU·AI 클러스터 관리였으며, 확대 범위는 모델 학습·추론, 토큰 사용량 관리, AI 에이전트 운영이다.
이 같은 확대는 AI 확산 단계가 연구개발을 넘어 산업·서비스로 옮겨가는 상황과 맞물린다. 래블업은 인프라부터 실제 업무 수행까지 전 과정을 하나의 운영 체계로 연결할 계획이다.
신정규 래블업 대표는 29일 서울 코엑스에서 열린 연례 기술 콘퍼런스 'lab | up > /conf/6'의 오프닝 키노트를 진행했다. 오프닝 키노트의 주제는 'AI 산업 시대의 엔드투엔드에 대하여'였다.
신정규 대표는 인프라 구축·모델 학습·추론·서비스 운영의 분리 관리를 벗어나 전체 과정을 연결할 필요가 있다고 밝혔다. 이를 위한 기준으로는 '토큰·전력·지력'을 제시했다. 그는 AI 사용 토큰을 측정하고, 연산에 필요한 전력을 측정하며, 동일한 토큰 양으로 해결 가능한 문제 수준을 측정할 필요가 있다고 설명했다.
그는 AI 활용에서 동일한 토큰 기준 지능 압축 확대가 중요하다고 강조했다. 그는 또 필요 지능 수준과 문제 해결에 투입되는 토큰량을 동시에 계산할 필요가 있다고 언급했다.
이어 신 대표는 AI 인프라를 제조 공장에 비유했다. 그는 공장 운영 과정이 제품을 생산하고 검사한 뒤 수량과 비용을 계산해 목적지로 발송하는 방식이라고 설명했다.
신 대표는 AI 운영에도 이에 대응하는 체계가 필요하다고 밝혔다. 그는 그 체계가 모델을 학습·서빙하고, 사용량을 측정하며, 필요한 서비스를 공급하는 방식이라고 설명했다.
래블업은 이 같은 체계를 '토큰 팩토리(Token Factory)'로 구체화하고 있다고 소개했다. '토큰 팩토리(Token Factory)'는 컴퓨팅 자원, 모델 실행, 요청 분배, 토큰 사용량, 에이전트 서비스가 단계별로 연결되는 구조다.
이 구조의 기반 플랫폼은 AI 인프라 플랫폼 '백엔드닷AI(Backend.AI)'다. '백엔드닷AI(Backend.AI)'는 GPU·NPU 등 AI 가속기 자원 관리를 지원하며, 지원 범위를 대규모 모델 학습·추론과 이기종 클러스터 운영으로 확대하고 있다.
래블업은 최신 인프라 변화에 맞춰 엔비디아 GB200 NVL72 지원을 완료했고, 차세대 베라 루빈(Vera Rubin) 아키텍처 대응도 준비 중이다. GB200 NVL72 구조는 72개 블랙웰 GPU의 단일 NVLink 도메인 연결이다. GB200 NVL72 요구사항은 기존 서버 단위 자원 관리와 다른 접근이다.
래블업은 대규모 학습 환경에서 장애 복구 속도 향상에 중점을 두고 있다. 수백 장 GPU의 장기 가동 시에는 일부 장비의 장애를 회피하기 어렵고, 복구 시간은 전체 학습 기간에 직접 영향을 준다.
래블업은 업스테이지 '솔라 오픈(Solar Open) 100B' 학습을 진행했다. 이 과정에서 래블업의 인프라 자동화와 업스테이지의 학습 코드 최적화를 결합했고, 예상 학습 기간을 약 120일에서 66일로 단축했다.
래블업은 관제 범위를 확대했다. 'all-smi' 기반으로 GPU·NPU·CPU 상태 확인을 지원하고, 전력·발열 정보의 통합 확인도 지원한다. 또 쿠버네티스와 슬럼(Slurm) 환경의 상위 계층 통합 운영도 지원한다.
래블업은 지원 가능한 가속기 범위를 엔비디아 중심에서 AMD·인텔 등으로 넓히고 있다. AI 가속기에 대한 지원도 단계적으로 확대하고 있으며, 대상에는 퓨리오사AI·리벨리온이 포함된다.
래블업은 행사에서 '컨티넘(Continuum)'을 공개했다. 컨티넘은 모델 요청을 관리하고 토큰 사용량을 관리하는 기능을 갖췄다.
컨티넘은 요청 분배 라우터와 전체 사용 현황을 확인하는 허브로 구성된다. 이 가운데 라우터는 오픈AI·앤트로픽·아마존 베드록·구글 제미나이 등 외부 AI 서비스와 기업 내부 모델을 연결하는 구조다.
자체 서빙 환경과의 연동도 가능하다. 연동 가능한 환경은 vLLM·SGLang·MLXCell·Ollama·llama.cpp다.
컨티넘은 응답 속도·비용·서비스 상태를 기준으로 요청을 분배하도록 설계됐다. 외부 클라우드 API에 장애가 발생하면 요청을 자체 모델로 전환할 수 있으며, 서비스 수준 목표에 맞춰 모델을 선택하는 것도 가능하다.
컨티넘은 조직별 AI 사용량을 계량하는 역할을 한다. 팀·서비스 단위의 토큰 소비량을 확인할 수 있고, 팀·서비스 단위의 비용도 확인할 수 있다. 또한 모델 변경 이후의 비용 변화와 캐시 적용 이후의 비용 변화를 추적할 수 있다.
신 대표는 토큰 사용을 전기 사용에 비유하며 계량의 필요성을 강조했다. 그는 절감 규모를 확인할 필요가 있고, 팀별 토큰 사용량도 확인할 필요가 있다고 설명했다.
래블업은 컨티넘과 엔비디아 추론 소프트웨어 다이나모(Dynamo)를 병행 활용하는 방안을 제시했다. 다이나모는 클러스터 내부의 추론 최적화를 담당하고, 컨티넘은 외부 클라우드와 자체 모델 간 요청 분배를 담당하는 구조다.
컨티넘 라우터는 향후 로컬 AI 플랫폼 AI:GO에도 적용할 예정이다. 독립형 라우터와 기업용 허브를 제공하며, 이를 기반으로 클라우드와 자체 모델을 통합 관리하는 환경을 지원한다.
에이전트 확산에 따라 CPU·I/O도 관리 대상이 된다.
AI 에이전트의 확산으로 인프라 관리 대상이 확대되고 있다. 모델 추론을 담당하는 자원은 GPU지만, 에이전트는 파일 읽기·코드 빌드·테스트·외부 정보 수집 과정도 수행한다. 이 과정에서 사용하는 자원은 CPU·메모리·저장장치·네트워크까지 포함된다.
복수 에이전트가 동시에 작업할 경우 자원 간섭이 발생할 수 있다. 특정 에이전트의 디스크 입출력(I/O)·네트워크 사용량이 다른 작업에 영향을 줄 수 있다. 기존 컨테이너 환경은 CPU·메모리·저장장치·네트워크 자원을 세밀하게 격리하기 어려운 한계가 있다.
래블업은 해결책으로 '누빔(NeuVM)'을 개발 중이다. '누빔(NeuVM)'은 마이크로 가상머신(VM)과 컨테이너를 결합해 에이전트별 자원을 분리하면서 일반 VM보다 가상화 부담을 낮추는 기술이다. '누빔(NeuVM)'의 목적은 에이전트별 자원 분리이고, 특성은 일반 VM 대비 가상화 부담 축소다.
'누빔(NeuVM)'은 에이전트 단위로 마이크로VM을 배치하고 내부에서 컨테이너를 실행하는 방식으로 동작한다. 래블업은 연말 베타 버전 공개를 준비하고 있다고 설명했다.
래블업이 AI 에이전트 직접 운영용 플랫폼을 개발했다. 이 플랫폼은 인프라 상에서 에이전트 생성·실행·외부 도구 호출·권한 관리·결과 평가를 연결해 하나의 흐름으로 묶는 구성을 취한다.
구성 요소는 생성과 배포를 맡는 '에이전트 팩토리(Agent Factory)', 실행 안정성과 격리를 담당하는 '에이전트 런타임(Agent Runtime)', 외부 호출과 통제를 집중시키는 '에이전트 게이트웨이(Agent Gateway)'로 나뉜다.
'에이전트 팩토리(Agent Factory)'는 자연어 업무 설명 기반 에이전트 생성을 지원한다. 또 쿠버네티스 환경 실행을 지원하고, 외부 프레임워크 제작 에이전트의 병행 운영도 지원한다.
'에이전트 런타임(Agent Runtime)'은 다중 작업 병렬 처리를 지원한다. 또 장애·재시작 후에도 세션·상태를 유지한다. 생성 코드는 컨테이너·마이크로VM 기반 샌드박스에서 실행되며, 이는 작업 영역 분리를 위한 것이다.
'에이전트 게이트웨이(Agent Gateway)'는 외부 서비스 호출과 권한 관리를 담당한다. 또한 모델 요청, 정책, 가드레일, 사람 승인, 팀별 예산, 감사 기록을 중앙 통제한다.
래블업은 에이전트 생성부터 운영·평가까지 반복하는 체계를 제시했다. 이 체계에는 운영 이후 단계의 포함 항목으로 실행 결과·도구 사용·안전성·비용 평가가 들어가며, 개선안 재검증 절차도 포함된다.
래블업은 에이전트 플랫폼 API를 활용한다고 밝혔다. 또 사람과 복수 AI 에이전트가 업무를 주고받는 공간인 '스페이스(Space)'를 구현했으며, '스페이스(Space)'를 자체 플랫폼 API 기반 협업 환경의 적용 사례로 제시했다.
회사 측은 향후 추가 예정 사항도 발표했다. 추가 예정 기능으로는 '툴 스튜디오(Tool Studio)'와 '워든(Warden)'이 있으며, '툴 스튜디오(Tool Studio)'는 코드 없이 기업 내부 시스템과 에이전트를 연결하는 기능이고, '워든(Warden)'은 작업 위험도에 따라 자동 실행 여부와 사람 승인을 결정하는 기능이다.
래블업의 엔드투엔드 전략은 대규모 데이터센터뿐 아니라 로컬 AI 환경까지 확장된다. 회사는 이 같은 전략 범위를 데이터센터에만 두지 않고 로컬 AI 환경으로도 이어가고 있다.
그 사례로 'AI:GO'가 제시됐다. 'AI:GO'는 올해 1월 정식 출시된 개별 PC에서 AI 모델을 실행할 수 있는 데스크톱 AI 플랫폼이며, 여러 장비의 자원을 연결하는 기능도 갖췄다.
여러 PC를 'GO Mesh'로 연결할 수 있고, 서로 다른 장비 간 모델 분산 실행도 가능하다. 에이전트 기능으로는 파일 편집과 웹 검색, 코드 실행을 제공하며, 이를 통해 에이전트의 실제 업무 수행을 지원한다.
래블업은 백엔드닷AI로 학습·추론 인프라를 운영하고, 컨티넘으로 모델 요청 관리와 토큰 사용량 관리를 맡길 계획이다. 또 에이전트 플랫폼과 AI:GO를 통해 실제 서비스·업무를 연결하는 구조를 구상하고 있다.
AI의 산업 현장·기업 업무 확산에 따라 관리 대상은 GPU와 모델 성능, 토큰 비용, CPU 자원, 네트워크 자원, 에이전트 권한, 에이전트 행동으로 확대되고 있다. 이에 따라 래블업은 인프라·모델·에이전트의 단일 체계 운영을 주력으로 삼고, 운영 복잡성 저감을 목표로 하고 있다.
신 대표는 AI 활용이 시작된 뒤에도 인프라의 지속적 필요성이 있다고 밝혔다. 또 복잡한 AI 인프라 문제를 직관화·단순화하는 방향으로 추진하고, 누구나 지능을 계량하고 필요 시 사용할 수 있도록 하겠다는 방침을 밝혔다.
출처: 테크월드뉴스 · 김승기 기자
원문: https://www.epnc.co.kr/news/articleView.html?idxno=407488
참고자료
이 기사는 자동생성 알고리즘의 도움을 받아 작성되었습니다.
출처 테크월드뉴스
원문 확인이 기사는 테크월드뉴스 원문을 바탕으로 비즈크러시가 요약 정리했습니다. 정확한 인용과 세부 내용은 원문을 확인해 주세요.