구글, 컴퓨터 비전도 보상 기준으로 다시 훈련
인공지능신문 ·
✦ AI 요약
컴퓨터 비전도 강화학습 시대…정답 데이터 맞히는 AI에서 ‘실제 업무를 잘하는 AI’로 진화
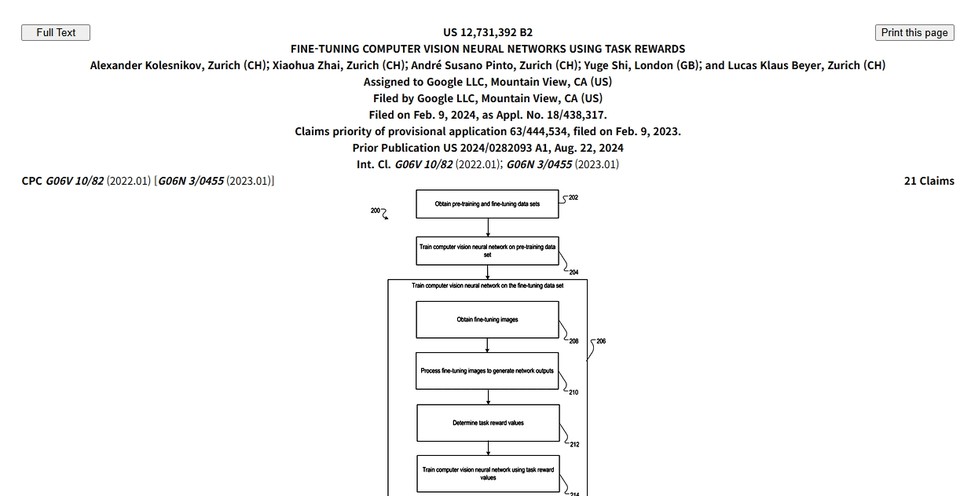
인공지능신문에 따르면 구글은 미국 특허 제12731392호를 통해 컴퓨터 비전 모델을 정답 데이터에만 맞추지 않고 실제 업무 성과를 보상으로 삼아 다시 학습시키는 방식을 제시했다. 9월 14일 소개된 이 특허는 사전학습 뒤 강화학습 기반 미세 조정을 거쳐, 모델이 현장에서 중요한 평가 기준을 직접 목표로 삼게 하는 데 초점을 둔다. 핵심은 학습 데이터의 정답을 잘 흉내내는 것과 실제 환경에서 일을 잘하는 것이 다를 수 있다는 문제의식이다. 이에 따라 객체 탐지나 이미지 분할, 컬러화처럼 서로 다른 과제에서도 현장 성능을 더 잘 반영하는 기준을 학습에 연결하는 길을 열었다. 특히 보상 함수가 꼭 미분 가능한 형태일 필요가 없다는 점을 내세워, 사람이 내린 평가나 복합적인 성능 판단도 학습 목표로 끌어올 수 있다고 짚었다. 글은 이를 생성형 AI의 정렬 흐름이 컴퓨터 비전과 피지컬 AI로 번지는 신호로 해석하며, 앞으로는 큰 모델 자체보다 목표를 어떻게 보상으로 설계하느냐가 경쟁력이 될 수 있다고 봤다.
관점
이 사안의 의미는 비전 AI의 경쟁 축이 정확도 중심에서 목적 달성 중심으로 옮겨간다는 데 있다. 이렇게 되면 기술 우위는 더 많은 정답 데이터를 쌓는 능력만이 아니라, 현장의 실패 비용과 성공 기준을 학습 구조에 얼마나 잘 반영하느냐에서 갈릴 가능성이 크다. 결국 모델 개발과 평가, 배치의 경계가 더 촘촘해지고, 실제 운영 환경을 이해하는 쪽이 더 유리해지는 흐름으로 읽힌다.
이 관점은 비즈크러시가 작성한 자체 의견이며, 인공지능신문의 보도 내용과 무관합니다.
이 기사는 자동생성 알고리즘의 도움을 받아 작성되었습니다.
출처 인공지능신문
원문 확인이 기사는 인공지능신문 원문을 바탕으로 비즈크러시가 요약 정리했습니다. 정확한 인용과 세부 내용은 원문을 확인해 주세요.