Intel GPU「D270」、AI推論を超えてHPC市場を狙う
IT DAILY ·
✦ AI 要約
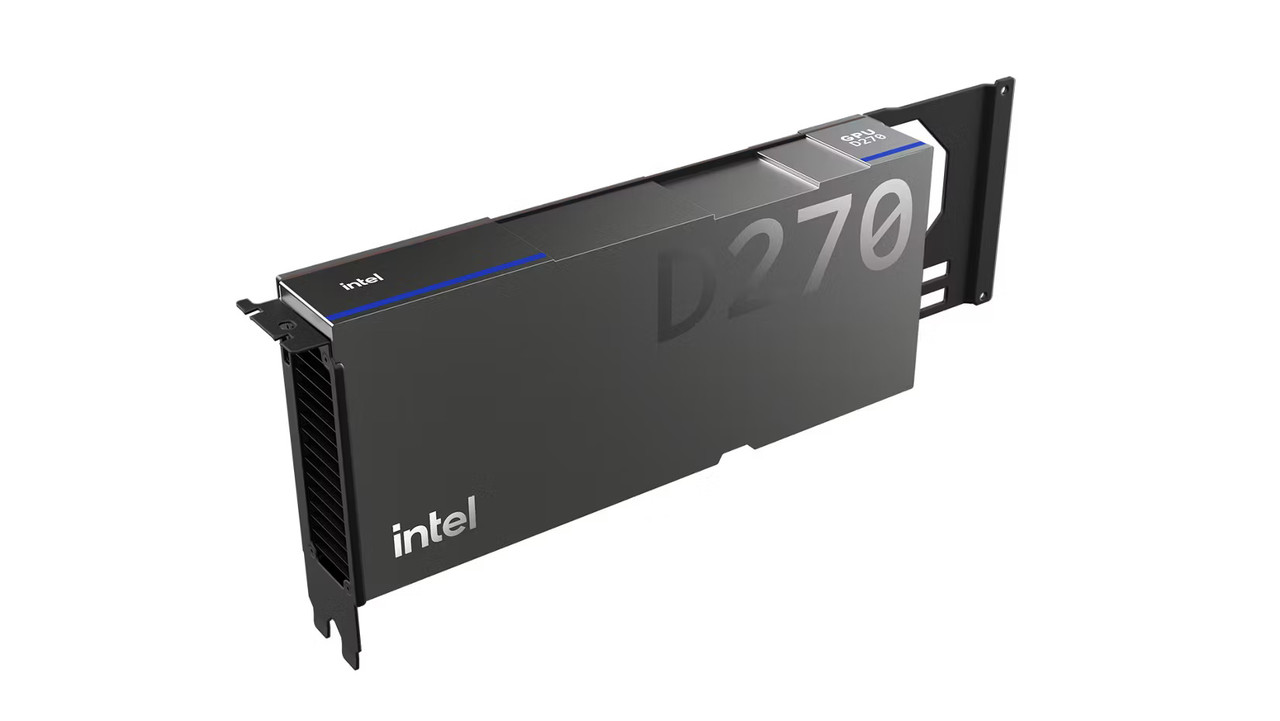
Intelは17日、データセンター向けGPU「Intel GPU D270」の活用範囲をAI推論からHPCまで拡張すると発表した。
D270はIntel Xe 3Pアーキテクチャを基盤に、32個のXeコアと256個のXMXエンジン、160GB LPDDR5Xと毎秒1.5TBのメモリー帯域幅を備えた。
IntelはSC26で、地震探査シミュレーションと分離型異種混在推論アーキテクチャをリアルタイムでデモする計画である。
BizCrush韓国語の発表やライブを、リアルタイムで聴きたいならCapCrush(Web版)を試す
Intelは17日、データセンター向けGPU「Intel GPU D270」の活用範囲を拡大すると発表した。適用範囲はAI推論からHPCまでである。
この拡大の背景には、最近の科学研究・産業界の潮流がある。従来の数値モデリング・シミュレーションとデータ分析・AI推論を単一のワークフローとして結合する動きが加速しており、agentic AIはデータと専門ツールを自律ループでつなぎ、シミュレーション・パラメータをリアルタイムで調整する。
こうした変化に伴い、計算段階ごとに最適なプロセッサーを組み合わせる異種混在インフラへの需要も拡大している。Intel GPU D270は、このようなHPC・AI融合ワークロードに対応する目的で開発された。
Intel GPU D270はIntel Xe 3Pアーキテクチャを基盤とする。32個のXeコアと256個のXe Matrix Extensions(XMX)エンジンを搭載し、各コアは64回のFP64 fused multiply-add(FMA)演算をサポートする。
同製品はFP4からFP8の低精度推論からFP64ネイティブ倍精度の科学・金融シミュレーションまでを網羅するよう設計された。メモリー・プラットフォーム設計の焦点は、大規模データ処理に置かれている。
Intelブランドカードは標準で160GB LPDDR5Xを搭載し、メモリー帯域幅は毎秒1.5TBをサポートする。パートナー設計構成では、最大メモリー容量は480GBまで可能である。これにより、膨大なデータセットや波動場配列をGPUメモリーに常駐させ、ホストバス間のデータ移動ボトルネックを減らす狙いである。
電力設計は350Wで、フォームファクターは標準空冷式PCIe 5.0である。適用対象環境は既存のエンタープライズサーバーとラックだ。量産前のシリコンベースのアプリケーション・ベンチマーク結果では、電力に対する処理効率が高いことが示された。
金融サービスのオプション価格算定テストでは、比較対象としてNvidiaのRTX PRO 6000 Blackwell Server Edition(600W)が示された。このテストでD270(350W)は、欧州型モンテカルロのスループットが5.9倍高く、欧州型ブラック-ショールズのスループットが5.6倍高く、Binomialのスループットが4.6倍高く、米国型ブラック-ショールズのスループットが1.92倍高かった。
性能比較では、agentic AI・LLM推論テストを基準に、同一の競合製品に比べて「Drex 2.0」意思決定モデルのレイテンシーが最大29%減少したと示された。さらに「Qwen 3 30B-A3B」モデルでは、スループットが1.12倍向上した。
ソフトウェア面では、オープンなエコシステムを基盤に既存のHPCコードベースの移植性を保証するとした。対応項目にはIntel MPI、Fortran、C++コンパイラー、標準AIフレームワーク、オープンなSYCLプログラミングモデルが含まれる。これにより、開発者は独自言語を基盤にコードを書き直す必要がないと説明された。
Intelはシカゴで開かれるスーパーコンピューティング展示会「SC26」で、リアルタイムデモに乗り出す計画である。デモ対象は地震探査シミュレーションと分離型異種混在推論アーキテクチャだ。地震波モデリング分野では、キャッシュ特性を反映したステンシル最適化と大容量メモリーの結合が公開され、これにより膨大な3次元音響波伝搬計算が加速する内容が示された。
ターンキー方式の分離型推論インフラが公開された。このインフラは、推論過程を段階別の特性に合わせて分離し、計算段階ごとのボトルネックを解消することを目的とする。高次元シミュレーションデータ・大規模コンテキストを処理する計算集約的な段階であるprefillはIntel GPU D270が担当する。メモリー帯域幅への依存度が高いdecode段階はSambaNovaのSN50再構成可能データフロー・ユニットが担当する。全体のワークフローオーケストレーションとツール実行の総括はIntel Xeon 6およびXeon 6+プロセッサーが担う。
出典:IT DAILY · クォン・ヨンソク 原文:https://www.itdaily.kr/news/articleView.html?idxno=242994
参考資料
本記事は、IT DAILYの原文をもとにBizCrushがAIを用いて要約・再構成・編集したものであり、IT DAILYの原文そのものではありません。
出典 IT DAILY
原文を確認本記事は、IT DAILYの原文をもとにBizCrushが要約・編集したものです。正確な引用や詳細は原文をご確認ください。
あわせて見る
BizCrush