Intel GPU 'D270',瞄準 AI 推論以外的 HPC 市場
IT DAILY ·
✦ AI 摘要
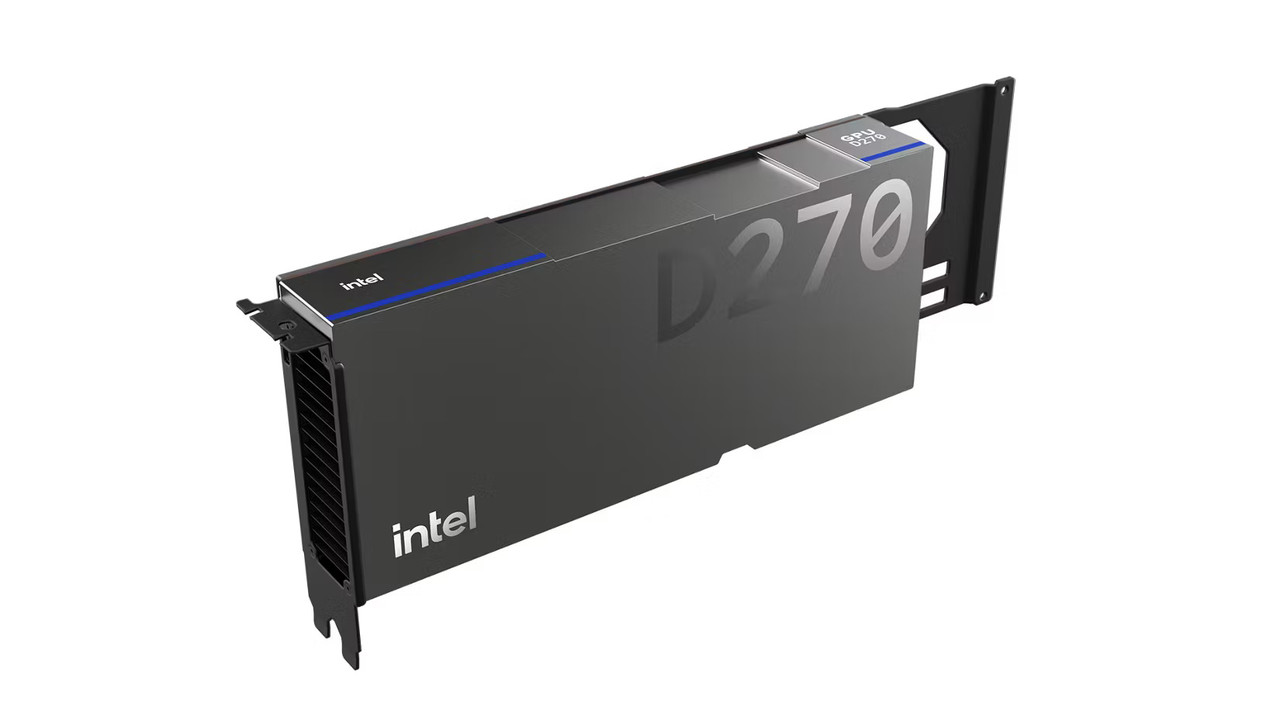
Intel 於 17 日宣布,將資料中心用 GPU「Intel GPU D270」的用途從 AI 推論擴大到 HPC。D270 採用 Intel Xe 3P 架構,配備 32 個 Xe 核心與 256 個 XMX 引擎,以及 160GB LPDDR5X 和每秒 1.5TB 記憶體頻寬。Intel 並將在 SC26 上即時展示地震探勘模擬與分離式異質推論架構。
BizCrushWant to follow Korean talks and live streams in real time?Try CapCrush on the web
Intel 於 17 日宣布,將擴大資料中心用 GPU「Intel GPU D270」的應用範圍。適用範圍從 AI 推論延伸到 HPC。
這項擴大的背景,來自近期科學研究與產業界的趨勢。傳統數值建模與模擬、資料分析與 AI 推論,正加速整合為單一工作流程;而 agentic AI 會以自律迴圈連結資料與專業工具,並即時調整模擬參數。
隨著這些變化,將每個運算階段的最佳處理器組合起來的異質基礎架構需求也在擴大。Intel GPU D270 正是為了因應這類 HPC·AI 融合工作負載而開發。
Intel GPU D270 以 Intel Xe 3P 架構為基礎。這款產品搭載 32 個 Xe 核心與 256 個 Xe 矩陣延伸(XMX)引擎,且每個核心支援 64 次 FP64 融合乘加(FMA)運算。
該產品的設計涵蓋範圍從 FP4~FP8 低精度推論,到 FP64 原生倍精度科學與金融模擬。其記憶體與平台設計則以大規模資料處理為重點。
Intel 品牌卡標配 160GB LPDDR5X,記憶體頻寬支援每秒 1.5TB。在合作夥伴設計的配置中,最高記憶體容量可達 480GB。藉此將龐大資料集與波場陣列常駐於 GPU 記憶體中,降低主機匯流排間資料移動的瓶頸。
功耗設計為 350W,外形規格為標準風冷 PCIe 5.0。適用環境為既有企業伺服器與機櫃。在量產前的矽晶片基礎應用基準測試結果中,其被呈現為具有較高的功耗比處理效率。
在金融服務選擇權定價測試中,對比對象為 NVIDIA RTX PRO 6000 Blackwell Server Edition(600W)。在這項測試中,D270(350W)的歐式蒙地卡羅處理量高出 5.9 倍、歐式布萊克-休斯處理量高出 5.6 倍、Binomial 處理量高出 4.6 倍、美式布萊克-休斯處理量高出 1.92 倍。
在效能比較方面,以 agentic AI 與 LLM 推論測試為基準,與同一競爭產品相比,Drex 2.0(Drex)決策模型的延遲時間最高減少 29%。此外,以 Qwen 3 30B-A3B 模型為基準,處理量提升 1.12 倍。
在軟體面,Intel 表示,該產品以開放式生態系為基礎,可確保既有 HPC 程式碼庫的可攜性。支援項目包括 Intel MPI、Fortran、C++ 編譯器、標準 AI 框架與開放式 SYCL 程式設計模型。據此,開發者無須以專有語言重新撰寫程式碼。
Intel 計畫在於芝加哥舉行的超級運算展覽會 SC26 上進行即時展示。展示對象包括地震探勘模擬與分離式異質推論架構。在地震波建模部分,將公開反映快取特性的 stencil 最佳化與大容量記憶體結合,並說明這將加速龐大的 3D 聲波傳播運算。
一套 turnkey 方式的分離式推論基礎架構也已公開。此基礎架構的目的,是依照推論過程各階段的特性加以分離,以消除各運算步驟的瓶頸。處理高維度模擬資料與大規模 context 的高運算密集階段 prefill,由 Intel GPU D270 負責。高度依賴記憶體頻寬的 decode 階段,由 SambaNova 的 SN50 可重組資料流單元負責。整體工作流程編排與工具執行總覽則由 Intel Xeon 6 與 Xeon 6+ 處理器負責。
來源: IT DAILY · Kwon Yeong-seok 原文: https://www.itdaily.kr/news/articleView.html?idxno=242994
參考資料
本文由 BizCrush 在自動生成演算法的協助下撰寫。
來源 IT DAILY
查看原文本文由 BizCrush 根據 IT DAILY 原文摘要整理。準確引文與細節請參閱原文。
Keep reading
BizCrush